Узнайте, когда стоит использовать модели рассуждения и чем они отличаются от моделей GPT.
OpenAI предлагает два типа моделей: модели рассуждения (например, o1 и o3-mini) и модели GPT (такие как GPT-4o). Эти семейства моделей работают по-разному.
В этом руководстве рассмотрены:
- Различия между моделями рассуждения и стандартными моделями GPT
- Сценарии использования моделей рассуждения
- Эффективные методы создания запросов для моделей рассуждения
Модели рассуждения vs. Модели GPT
По сравнению с моделями GPT, модели серии o демонстрируют лучшие результаты в определённых задачах и требуют другого подхода к созданию запросов. Ни одно из семейств моделей не является лучше другого — они просто разные.
Мы обучили модели серии o («планировщики») глубже анализировать сложные задачи, что делает их эффективными для стратегического планирования, поиска решений для комплексных проблем и принятия решений на основе больших объёмов неоднозначной информации. Эти модели способны выполнять задачи с высокой точностью и аккуратностью, что делает их идеальными для областей, где обычно требуется участие эксперта — например, в математике, науке, инженерии, финансовых и юридических услугах.
С другой стороны, модели GPT с низкой задержкой и оптимальной стоимостью («рабочие лошадки») предназначены для простого и быстрого выполнения задач. В некоторых случаях приложение может использовать модели серии o для планирования стратегии решения задачи, а затем задействовать модели GPT для выполнения конкретных задач, особенно когда скорость и стоимость важнее абсолютной точности.
Как выбрать подходящую модель
Что является приоритетом для вашего сценария использования?
- Скорость и стоимость → модели GPT работают быстрее и обычно дешевле
- Выполнение чётко определённых задач → модели GPT отлично справляются с явно заданными задачами
- Точность и надёжность → модели серии o обеспечивают высокую надёжность при принятии решений
- Решение сложных задач → модели серии o способны работать с неоднозначностью и сложными сценариями
Если для вас на первом месте скорость и стоимость, а задачи простые и чётко сформулированные, лучше выбрать модели GPT. Однако если приоритетом являются точность и надёжность, а вам нужно решить сложную многоэтапную задачу, оптимальным выбором станут модели серии o.
В большинстве сценариев использования ИИ целесообразно комбинировать обе модели: использовать серию o для планирования и принятия решений, а серию GPT — для выполнения конкретных задач.
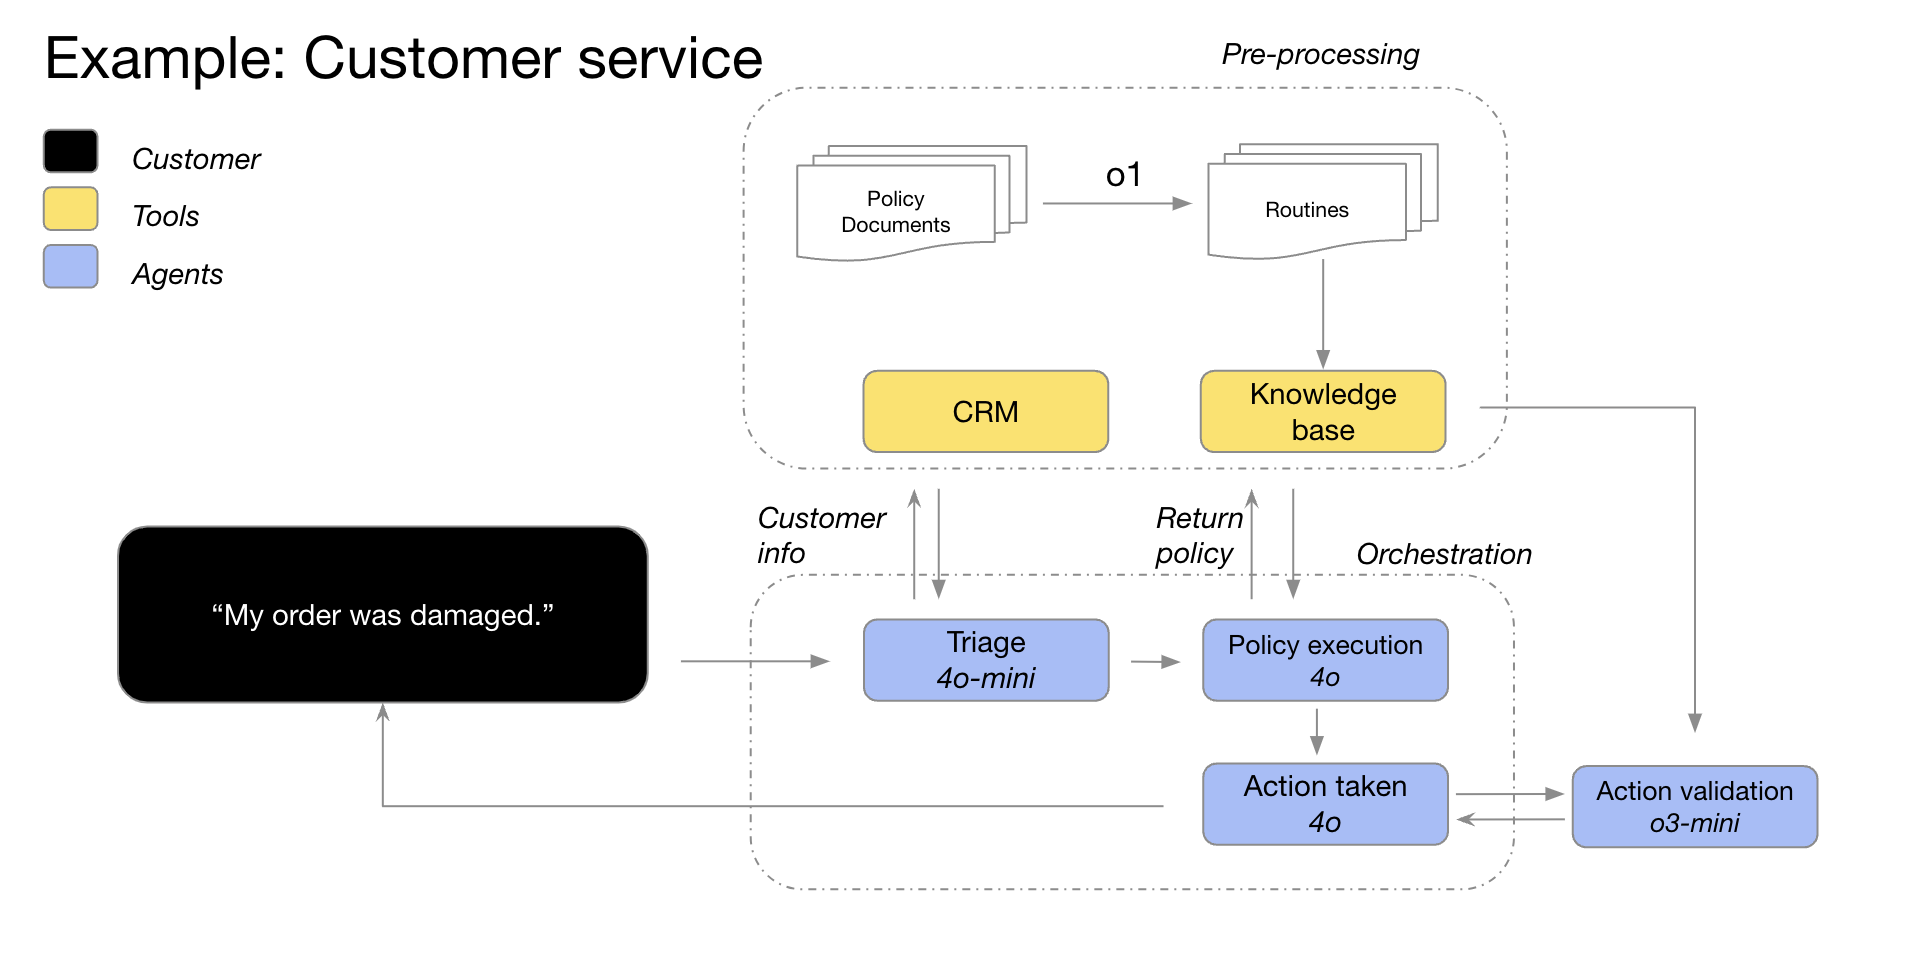
Наши модели GPT-4o и GPT-4o mini обрабатывают детали заказа вместе с информацией о клиенте, выявляют проблемы с заказом и политику возврата, а затем передают все эти данные в модель o3-mini для принятия окончательного решения о возможности возврата в соответствии с политикой.
Когда использовать модели рассуждения
Ниже представлены несколько примеров успешного использования моделей рассуждения, основанных на опыте клиентов и внутренней практике OpenAI. Это не полный список всех возможных сценариев, а практическое руководство для тестирования моделей серии o.
Работа с неоднозначными задачами
Модели рассуждения особенно эффективны при работе с ограниченной или разрозненной информацией. Даже при простом запросе они способны понять намерения пользователя и заполнить пробелы в инструкциях. Более того, модели рассуждения часто задают уточняющие вопросы, прежде чем делать предположения или пытаться восполнить недостающие данные.
«Возможности рассуждения модели o1 позволяют нашей мультиагентной платформе Matrix формировать исчерпывающие, структурированные и детализированные ответы при работе со сложными документами. Например, o1 помогла Matrix с лёгкостью выявить корзины активов, доступные в рамках ограниченной платёжной способности по кредитному соглашению, используя лишь базовый запрос. Ни одна из предыдущих моделей не показала аналогичной эффективности. В 52% случаев при работе с плотными кредитными соглашениями o1 обеспечила лучшие результаты на сложных запросах по сравнению с другими моделями.»
—Hebbia, Платформа ИИ для юридического и финансового секторов
Поиск иголки в стоге сена
При обработке больших объёмов неструктурированной информации модели рассуждения отлично справляются с задачей выделения наиболее значимых данных для ответа на запрос.
«Для анализа сделки по приобретению компании модель o1 изучила десятки корпоративных документов — таких как контракты и договоры аренды — чтобы выявить потенциально сложные условия, которые могли бы повлиять на сделку. Модель была настроена на поиск ключевых пунктов и в процессе обнаружила критически важное условие о «смене контроля» в сносках: в случае продажи компании ей необходимо было бы немедленно погасить кредит на сумму 75 миллионов долларов. Благодаря высокой внимательности к деталям модель o1 позволяет нашим ИИ-агентам оказывать поддержку финансовым специалистам, выявляя стратегически важную информацию.»
—Endex, Платформа ИИ для финансовой аналитики
Поиск связей и нюансов в большом наборе данных
Мы обнаружили, что модели рассуждения особенно эффективны при работе со сложными документами объёмом в сотни страниц, содержащими плотную, неструктурированную информацию — например, юридическими контрактами, финансовыми отчётами и страховыми заявлениями. Эти модели умеют выявлять параллели между различными документами и принимать решения, основываясь на скрытых взаимосвязях, заложенных в данных.
«Налоговое исследование требует синтеза информации из множества документов для формирования окончательного, логичного ответа. Мы заменили GPT-4o на o1 и обнаружили, что o1 гораздо лучше справляется с анализом взаимодействия между документами, позволяя прийти к логическим выводам, которые не очевидны в рамках отдельного документа. Благодаря этому производительность выросла в 4 раза — потрясающий результат.»
— Blue J, ИИ-платформа для налоговых исследований
Модели рассуждения также хорошо работают с многослойными политиками и правилами, эффективно применяя их к текущей задаче для получения обоснованных выводов.
«В финансовом анализе специалисты часто сталкиваются со сложными сценариями, связанными с акционерным капиталом, и должны учитывать все юридические тонкости. Мы протестировали около 10 моделей от разных провайдеров на типичном, но сложном вопросе: как привлечение инвестиций влияет на текущих акционеров, особенно если они используют свои антиразводняющие права? Для этого нужно было рассчитать до- и постинвестиционные оценки и учесть цикличные схемы разводнения — обычно на такой анализ у опытного аналитика уходит 20–30 минут. Мы обнаружили, что модели o1 и o3-mini справляются с этой задачей безупречно! Более того, они создали чёткую таблицу с расчётами, показывающую влияние на акционера с долей в $100 тыс.»
–BlueFlame AI, ИИ-платформа для инвестиционного управления
Многошаговое агентное планирование
Модели рассуждения играют ключевую роль в агентном планировании и разработке стратегий. Наилучшие результаты достигаются, когда модель рассуждения используется как «планировщик», создавая детализированное многошаговое решение задачи, а затем подбирая и распределяя подходящие модели GPT («исполнители») для каждого шага — в зависимости от того, что важнее: интеллектуальность или низкая задержка.
«Мы используем модель o1 в качестве планировщика в нашей агентной инфраструктуре, позволяя ей координировать работу других моделей в рамках сложного процесса. O1 отлично справляется с выбором типов данных и делением крупных вопросов на более мелкие задачи, что позволяет другим моделям сосредоточиться на выполнении конкретных операций.»
—Argon AI, Argon AI, ИИ-платформа для фармацевтической отрасли
«Модель o1 является основой многих наших агентных процессов в Lindy — нашем ИИ-ассистенте для работы. Она использует функцию вызова внешних данных для получения информации из календаря или электронной почты, а затем автоматически помогает планировать встречи, отправлять письма и управлять повседневными задачами. Мы перевели все проблемные этапы агентных процессов на o1 и увидели, как наши агенты практически сразу начали работать без ошибок!»
—Lindy.AI, ИИ-ассистент для работы
Визуальный анализ и рассуждение
На сегодняшний день модель o1 — единственная модель рассуждения с поддержкой обработки визуальных данных. Её главное отличие от GPT-4o заключается в способности понимать даже самые сложные визуальные элементы, такие как диаграммы и таблицы с нечеткой структурой или фотографии с низким качеством изображения.
«Мы автоматизируем проверки на соответствие требованиям и оценку рисков для миллионов товаров в интернете, включая подделки ювелирных изделий класса люкс, продукцию из исчезающих видов и контролируемые вещества. GPT-4o показала точность 50% при решении наших самых сложных задач по классификации изображений. o1 достигла впечатляющей точности в 88% без каких-либо изменений в нашем конвейере обработки данных.»
—SafetyKit, платформа управления рисками и соблюдением норм на базе ИИ
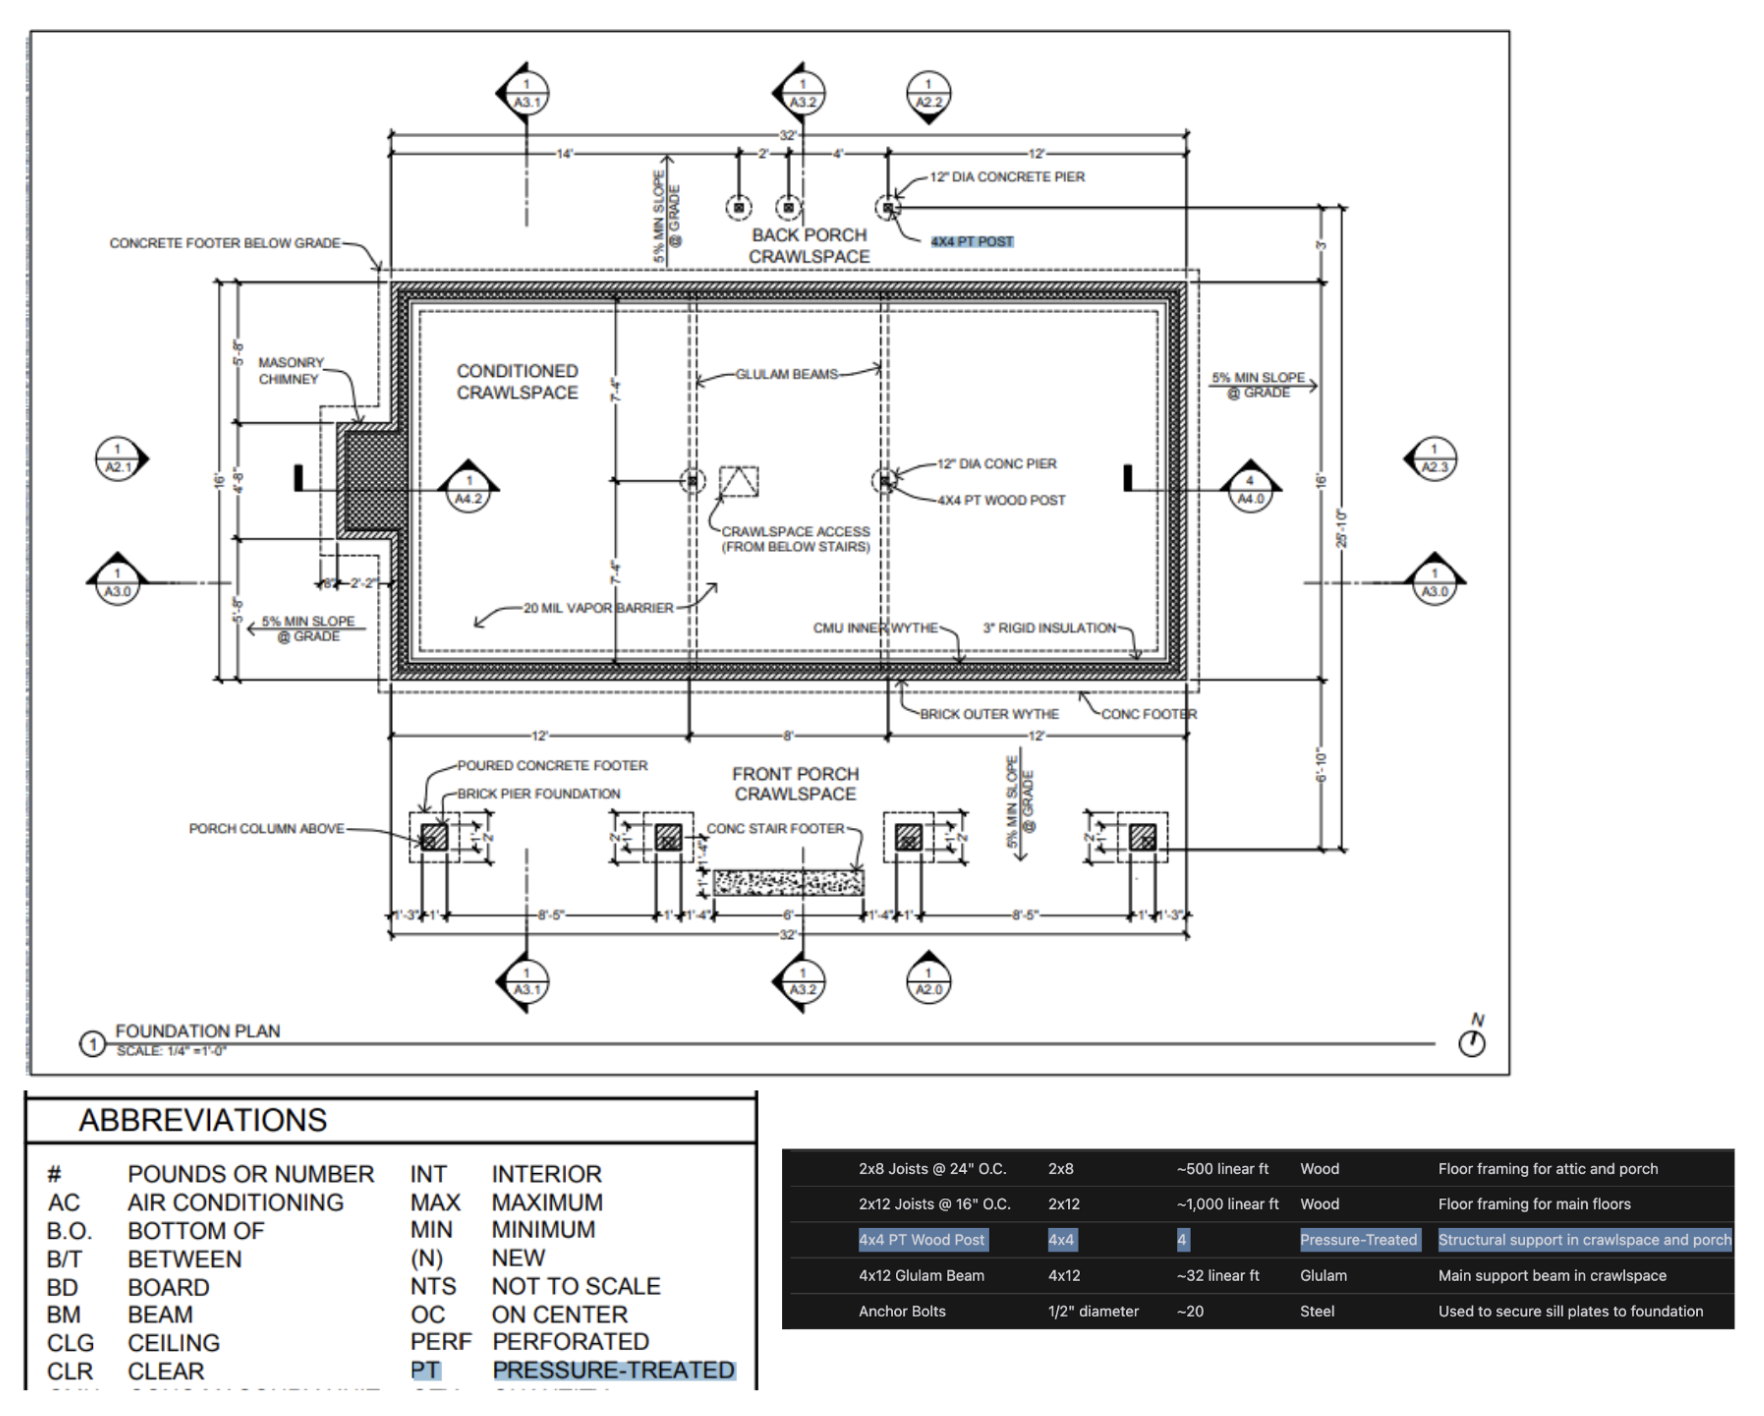
В ходе собственных внутренних тестов мы обнаружили, что модель o1 способна определять элементы и материалы на детализированных архитектурных чертежах для формирования полного спецификационного списка. Одним из самых впечатляющих наблюдений стало то, что o1 умеет проводить параллели между разными изображениями: она взяла условные обозначения с одной страницы чертежей и правильно применила их на другой странице без явных инструкций.
Например, для деревянных стоек 4×4 PT модель o1 поняла, что «PT» означает pressure treated (обработанная под давлением) на основе легенды.
Проверка, отладка и улучшение качества кода
Модели рассуждения особенно эффективны при анализе и улучшении больших объёмов кода, часто выполняя проверку в фоновом режиме благодаря своей способности справляться с высокими нагрузками, несмотря на повышенную задержку.
«Мы предоставляем автоматизированные проверки кода с помощью ИИ на таких платформах, как GitHub и GitLab. Хотя процесс ревью кода не критичен к задержкам, он требует глубокого понимания различий в коде между несколькими файлами. Здесь модель o1 показывает себя с лучшей стороны — она надёжно выявляет мелкие изменения в кодовой базе, которые могли бы ускользнуть от внимания человека. После перехода на модели серии o нам удалось утроить коэффициент конверсии продукта.»
—CodeRabbit, Стартап по автоматизированному ревью кода с помощью ИИ
Хотя модели GPT-4o и GPT-4o mini благодаря своей низкой задержке лучше подходят для написания кода, мы также наблюдали высокую эффективность модели o3-mini при работе с задачами, где задержка не является критичным фактором.
«Модель o3-mini стабильно генерирует качественный и завершённый код, часто находя правильное решение при чётко сформулированной задаче, даже если она довольно сложная. В то время как другие модели подходят лишь для мелких и быстрых итераций кода, o3-mini демонстрирует превосходные результаты в планировании и реализации сложных архитектурных решений для программного обеспечения.»
—Windsurf, Коллаборативная среда разработки на базе ИИ от Codeium
Оценка и бенчмаркинг ответов других моделей
Модели рассуждения также демонстрируют высокую эффективность при оценке и сравнении ответов других моделей. Валидация данных играет ключевую роль в обеспечении качества и надёжности датасетов, особенно в чувствительных сферах, таких как здравоохранение. В то время как традиционные методы проверки полагаются на заранее определённые правила и шаблоны, продвинутые модели, такие как o1 и o3-mini, способны учитывать контекст и проводить анализ данных, обеспечивая более гибкий и интеллектуальный подход к валидации.
«Многие клиенты используют LLM в роли «судьи» в рамках своей системы оценки на платформе Braintrust. Например, медицинская компания может использовать GPT-4o для составления краткого содержания вопросов пациентов, а затем применять o1 для оценки качества этого резюме. Один из клиентов Braintrust отметил, что показатель F1-метрики вырос с 0,12 (при использовании GPT-4o) до 0,74 с моделью o1! В подобных сценариях клиенты считают возможности рассуждения o1 революционными для обнаружения тонких различий в результатах, особенно при самых сложных задачах оценки.»
—Braintrust, Платформа для оценки ИИ-моделей
Как эффективно создавать запросы для моделей рассуждения
Эти модели показывают наилучшие результаты при работе с простыми и чёткими запросами. Некоторые приёмы prompt-инжиниринга, например указание модели «думать пошагово», не всегда улучшают производительность и в некоторых случаях могут даже снизить её.
Ознакомьтесь с лучшими практиками ниже…
- Сообщения разработчика заменяют системные сообщения:
Начиная с версии o1-2024-12-17, модели рассуждения поддерживают сообщения разработчика вместо системных сообщений. Это изменение соответствует логике иерархии команд, описанной в технической спецификации модели.
Лучшие практики для создания запросов к моделям рассуждения
Делайте запросы простыми и прямыми:
Модели лучше всего работают с краткими и чёткими инструкциями.
Избегайте цепочек рассуждений в запросах:
Модели выполняют рассуждения внутренне, поэтому инструкции вроде «думай пошагово» или «объясни ход рассуждений» не нужны и могут снизить эффективность.
Используйте разделители для ясности:
Применяйте разметку (например, Markdown, теги XML или заголовки разделов) для чёткого выделения разных частей входных данных. Это помогает модели правильно интерпретировать структуру информации.
Сначала попробуйте zero-shot, затем few-shot при необходимости:
Модели рассуждения часто дают отличные результаты без примеров в запросе (zero-shot). Если же задача сложная и требует уточнений, добавьте несколько примеров (few-shot). При этом убедитесь, что примеры максимально соответствуют инструкции — несоответствие может снизить качество результата.
Давайте чёткие ограничения:
Если вам нужно получить ответ в определённых рамках (например, «предложи решение с бюджетом до $500»), укажите эти ограничения явно в запросе.
Будьте максимально конкретны в описании конечной цели:
Задайте чёткие критерии успешного ответа и укажите, что модель должна продолжать рассуждать и уточнять ответ, пока он не соответствует этим критериям.
Форматирование Markdown:
Начиная с версии o1-2024-12-17, модели рассуждения в API по умолчанию избегают использования Markdown-разметки. Чтобы снова включить форматирование Markdown, добавьте строку Formatting re-enabled в начале сообщения разработчика.
Дополнительные ресурсы
Для получения дополнительных идей и примеров посетите OpenAI Cookbook, где вы найдете примеры кода и ссылки на сторонние ресурсы.
Также вы можете узнать больше о наших моделях и их возможностях рассуждения:


